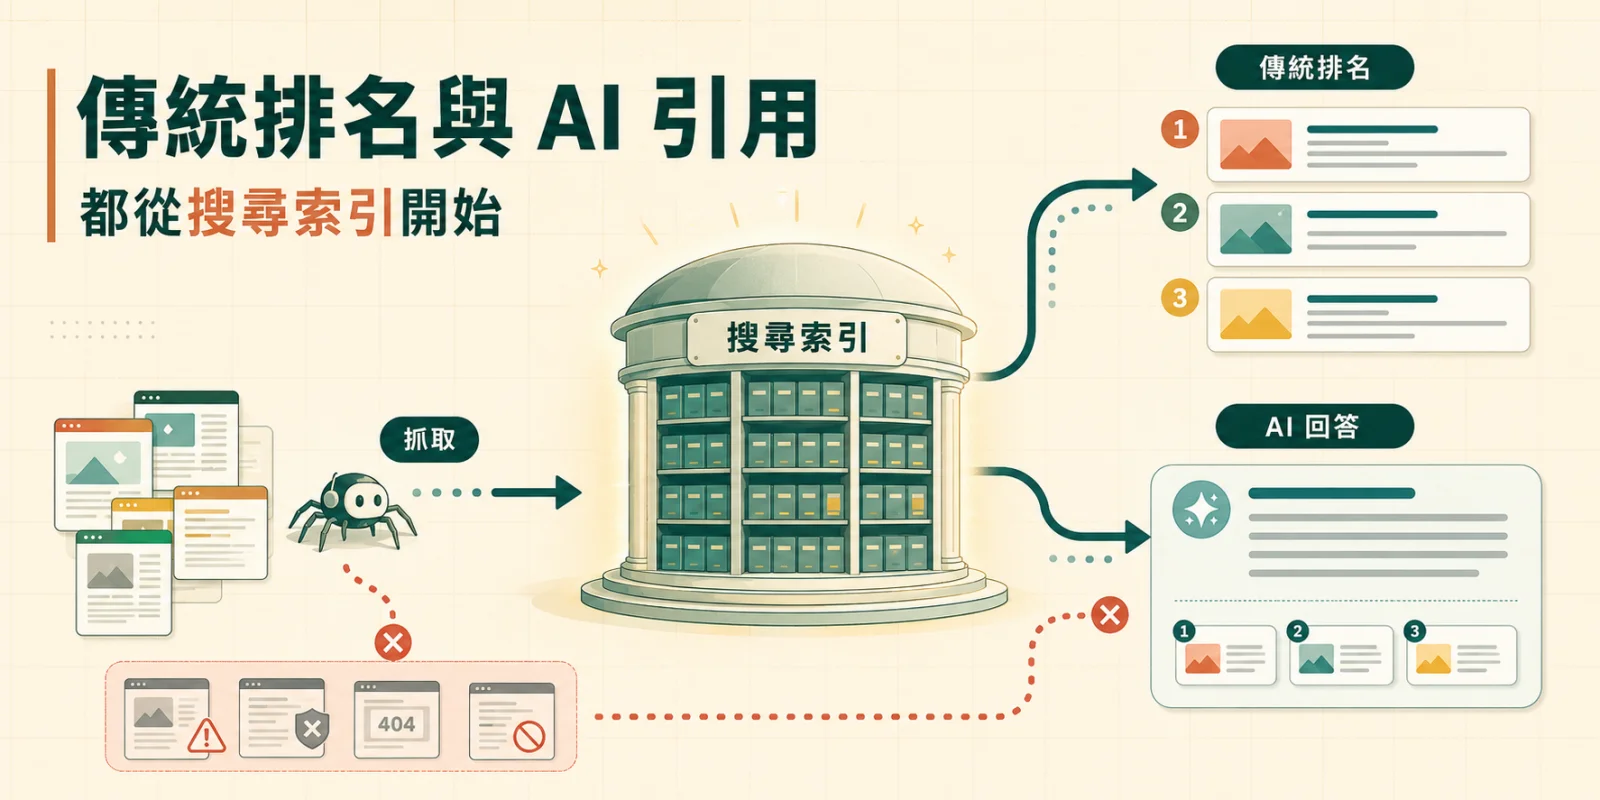
搜尋引擎如何運作?答案是三個步驟:抓取(Crawling)──派出檢索器沿著連結發現網頁;索引(Indexing)──解讀網頁內容並存入資料庫;排名(Ranking)──依演算法決定搜尋結果的順序。您的網頁必須先被抓取、再被編入索引,才有資格參與排名。而在 2026 年的今天,AI Overviews、AI 模式等 AI 搜尋的答案,同樣取自搜尋索引──抓取與索引沒做好,傳統排名與 AI 引用都輪不到您。
如果您還在建立 SEO 的整體觀念,建議先閱讀本站支柱文章〈SEO 是什麼?2026 初學者完整指南〉,再回來深入本篇的運作機制。
搜尋引擎如何運作?抓取、索引、排名三步驟
搜尋引擎的工作只有三件事:發現內容(抓取)、整理內容(索引)、排序內容(排名);SEO 的每一項技術工作,都是在這三個環節之一發揮作用。
搜尋引擎是為了回答搜尋者的問題而存在的:它持續發現、理解並組織網路上的內容,在有人搜尋時提出最相關的結果。三個步驟環環相扣,前一關沒過,後一關就不會發生:
| 步驟 | 搜尋引擎做什麼 | 您要確認的事 |
|---|---|---|
| 抓取 Crawling | Googlebot 沿著連結與 sitemap 發現網頁與更新 | 網頁有連結可達、robots.txt 沒有擋錯 |
| 索引 Indexing | 渲染網頁、解讀內容、存入索引資料庫 | 內容可被渲染、沒有誤植 noindex、canonical 正確 |
| 排名 Ranking | 依查詢意圖從索引中挑出結果並排序 | 內容符合搜尋意圖、具備 E-E-A-T 訊號 |

這是一個逐層縮小的漏斗。被抓取不保證被索引,被索引也不保證有排名。診斷 SEO 問題時,第一步永遠是先確認網頁卡在哪一關。
抓取:搜尋引擎找得到您的網頁嗎?
找不到就等於不存在:沒有被抓取的網頁,不會出現在任何搜尋結果頁(SERP),也不會被任何 AI 搜尋引用。
搜尋引擎派出檢索器(crawler,也稱搜尋蜘蛛,Google 的檢索器叫 Googlebot)在網路上發現與更新內容。檢索器先取得一批網頁,再沿著網頁上的連結找到新網址;網頁、圖片、影片、PDF 都在抓取範圍內,但不論哪種形式,內容都是靠「連結」被找到的。這也是為什麼內部連結結構與 sitemap 對抓取如此重要。
1. 先檢查:您的網站被收錄了多少網頁?
在 Google 搜尋「site:yourdomain.com」可以概略看到您的網站有哪些網頁被收錄,但顯示的結果數量並不精確,只能當參考。
要看準確資料,請使用 Google Search Console 的「網頁索引」報表:它會列出已建立索引的網頁數,以及「網頁無法編入索引」的具體原因(伺服器錯誤、404、被 noindex 排除、重複網頁等都整合在這份清單裡)。想查單一網址,用「網址審查」工具最直接。
我們替客戶做 Search Console 健檢時,最常見的其實不是「Google 完全找不到網站」,而是網頁卡在半路的三種狀態:「已找到,目前尚未建立索引」(多半是抓取排程未到或網站整體品質訊號不足)、「已檢索,目前尚未建立索引」(Google 抓了但判斷暫不收錄,常見於內容單薄或高度重複的網頁),以及「替代網頁(有適當的標準網頁標記)」(Google 選了其他版本作代表)。學會判讀這三種狀態,比單純數收錄頁數有用得多。
2. 網站沒被收錄的常見原因
- 網站剛上線,檢索器尚未抓到,也還沒有任何外部連結指向網站。
- 導覽結構或網站架構讓檢索器走不進去(詳見下方)。
- robots.txt 擋錯範圍,或網頁被誤植 noindex。
- 網站違反 Google 的垃圾內容政策而受到處置。
3. robots.txt:告訴檢索器哪裡不要去
robots.txt 放在網站根目錄,用來建議搜尋引擎哪些部分不要抓取。Googlebot 找不到這個檔案時會照常抓取整站;找到時通常會遵守其中的建議;但若嘗試讀取 robots.txt 時遇到伺服器錯誤、無法判斷檔案是否存在,Googlebot 可能暫停抓取整個網站──這是許多網站收錄異常的隱藏原因。
robots.txt 不是保密工具。它是一份公開檔案,把登入頁、後台網址寫進去,反而等於告訴有心人士私密內容在哪裡。想讓網頁不出現在搜尋結果,正確做法是用 noindex 標記,敏感內容再加上登入保護。
另外,robots.txt 也是您管理 AI 檢索器(GPTBot、PerplexityBot 等)的同一個地方,本文後段會再說明。
4. 檢索器看得到您的重要內容嗎?
即使網站被發現了,部分內容仍可能被擋在門外。自我檢查四件事:
- 內容是否藏在登入表單後面?檢索器不會登入、不會填表,登入牆後的內容一律看不到。
- 是否依賴站內搜尋欄?檢索器靠連結移動,不會使用您網站上的搜尋框找內容。
- 重要文字是否只放在圖片或影片裡?希望被索引的文字應以 HTML 文字呈現,不要只存在於圖像中。
- 導覽選單是否用標準 HTML 連結?若選單完全依賴 JavaScript 產生、或行動版導覽缺了桌機版才有的連結,檢索器可能走不到部分網頁。每個重要網頁都應該有站內連結指向它,孤島網頁(orphan page)是抓取的天敵。
5. 抓取時遇到錯誤:4xx、5xx 與轉址
4xx 是用戶端錯誤,最常見的 404(找不到網頁)通常來自網址打錯、網頁被刪除或轉址設定錯誤;5xx 是伺服器錯誤,代表伺服器無法回應請求。這些狀態現在都能在「網頁索引」報表中看到受影響的網址清單。
網頁搬家時,用 301(永久轉址)把舊網址指向新網址:它會傳遞舊網址累積的連結權重、幫助 Google 索引新版本,也讓使用者不會撞上錯誤頁。302 是暫時轉址,只用於短期借道的情境。
301 要轉到內容相對應的網頁。把舊文章一律轉回首頁,排名通常保不住——Google 會把這種轉址視為軟性 404,等於把舊網址累積的訊號丟掉。
索引:Google 如何解讀與儲存您的網頁?
通過抓取只是拿到入場券:Google 還要渲染您的網頁、以行動版內容為準、選出標準網址,網頁才會真正進入索引。
索引是搜尋引擎儲存與組織內容的巨型資料庫。檢索器取得網頁後,Google 會像瀏覽器一樣「渲染」網頁、分析文字與結構,再決定是否收錄、以哪個版本收錄。這一段有三個現代 SEO 必懂的機制:JavaScript 渲染、行動優先索引與 canonical。

1. JavaScript 渲染:Google 看到的和使用者一樣嗎?
Googlebot 使用與新版 Chrome 保持同步的無頭瀏覽器來渲染網頁,因此「Google 完全看不懂 JavaScript」已是過時的說法。但渲染需要額外的運算資源,可能被排入佇列延後處理;若網頁的主要內容與連結完全依賴 JavaScript 在瀏覽器端產生,索引就可能延遲或不完整。
實務上的保險做法:重要內容與連結盡量直接輸出在 HTML 中(伺服器端渲染或預先渲染),並用 Search Console 網址審查工具的「檢視已檢索的網頁」功能,確認 Google 渲染後的 HTML 裡確實看得到您的關鍵內容。
2. 行動優先索引:Google 只看您的行動版
Google 已於 2023 年 10 月宣布行動優先索引(mobile-first indexing)全面完成,這場轉換前後歷時近七年──現在 Google 一律以「行動版網頁的內容」作為索引與排名依據。如果您的行動版為了版面精簡而砍掉部分文字、結構化資料或內部連結,桌機版寫得再完整,Google 也看不到。行動版與桌機版的內容、meta 標記與結構化資料應保持一致。
3. canonical:告訴 Google 哪個網址是正本
同一份內容常會出現多個網址:帶參數的網址、排序與過濾器產生的變體、http 與 https、有無 www 等。Google 會從中選出一個「標準網址」(canonical)作代表,其餘視為重複。您可以用 rel="canonical" 標記主動指定正本,把分散的訊號集中到同一個網址上。
順帶更新一個舊觀念:Search Console 過去的「網址參數工具」已於 2022 年由 Google 正式下架──現在處理參數與重複網址,靠的是 canonical 標記、301 轉址與一致的內部連結,其餘交給 Google 自動判斷。
另外請記得 canonical 是強烈建議而非強制指令,Google 有可能另選版本,實際採用哪個網址可在網址審查工具中確認。
4. 用 meta robots 控制索引
想主動告訴搜尋引擎「這頁不要收錄」或「這頁的連結不要追蹤」,用 robots meta 標籤(寫在網頁 HTML 的 head 中)或 X-Robots-Tag(寫在 HTTP 標頭中,適合 PDF 等非 HTML 檔案或大範圍設定):
- noindex:不要將此網頁編入索引。適合內容單薄的網頁、站內搜尋結果頁、測試頁。
- nofollow:不要追蹤此網頁上的連結、不傳遞連結權重,通常與 noindex 搭配使用。
一個常見的致命組合錯誤:同時用 robots.txt 擋住抓取又寫了 noindex──Google 讀不到網頁,自然也讀不到 noindex 指令,網址反而可能以無內容的形式殘留在索引中。想確實移除收錄,要讓 Google 抓得到那頁的 noindex。
5. 想確認 Google 怎麼看您的網頁?用網址審查工具
過去教學常說「點搜尋結果旁的頁庫存檔(快取)」來查看 Google 眼中的網頁,這個功能已於 2024 年被 Google 正式移除,不必再找了。現在的標準做法是 Search Console 的「網址審查」工具:輸入網址即可看到收錄狀態、上次檢索時間、Google 選用的標準網址,並可用「檢視已檢索的網頁」查看 Google 實際取得的 HTML 與截圖;新網頁上線後也能在這裡「要求建立索引」。
6. 網頁為什麼會被移出索引?
已收錄的網頁仍可能被移除,主要原因包括:網址長期回應 4xx/5xx 錯誤、被加上 noindex、內容改為需要登入才能存取,或因違反 Google 的垃圾內容政策受到手動處置。
名稱也更新了:過去所稱的《站長指南》已於 2022 年改版為《Google 搜尋基本方針》(Search Essentials),判斷網站是否踩線請以新版為準。
排名:搜尋引擎如何決定誰排在前面?
排名的本質是媒合:Google 從索引中挑出最能滿足查詢意圖的網頁,由內容相關性、連結權威與使用者體驗共同決定順序。
有人搜尋時,Google 依演算法在索引中比對、排序,把它認為最相關、最有幫助的結果排在前面。演算法持續在變──小調整天天有,核心更新一年也有數次──但方向始終一致:獎勵真正回答搜尋者問題的內容。與其追逐每次更新,不如對照《Google 搜尋基本方針》與《搜尋品質評分者指南》(E-E-A-T 的出處)檢視自己的內容。
1. 連結:搜尋引擎眼中的口碑推薦
反向連結(backlink,別站連向您的連結)之於搜尋引擎,就像口碑之於實體店家:許多可信網站自然地連向您,是權威的訊號;自己說自己好(站內互連)分量有限;付費買來的低品質推薦不但沒有幫助,還可能觸犯垃圾內容政策。這正是 Google 早期核心演算法 PageRank 的基本邏輯──以連結的質與量評估網頁的重要性──連結至今仍是排名的重要訊號之一。
2. 內容:與搜尋意圖的匹配程度
連結把搜尋者帶到「內容」,內容才是完成任務的地方。Google 判斷的核心是:這個網頁是否滿足這次查詢背後的意圖?因此文章該多長、關鍵字該放幾次,並沒有神奇數字;早年把關鍵字塞好塞滿的做法,在今天只會做出難以閱讀的網頁。RankBrain、BERT 等機器學習系統讓 Google 越來越能理解語意與模糊的問題,寫給「人」看、直接回答問題的內容,才是這套系統要獎勵的對象。
3. 搜尋結果頁早就不只十個藍色連結
現代 SERP 佈滿各種功能:AI Overviews(AI 總覽)、精選摘要、相關問題(PAA)、本地地圖包、知識面板、購物結果等,自然結果的位置被不斷往下推。影響很實際:AI Overviews 全面上線後,Google 零點擊搜尋比例已由 56% 升至 69%(Similarweb,2025-07)。對策不是放棄,而是讓內容具備「被摘錄」的資格──答案先行、結構清楚、每個段落都能獨立回答一個問題。
互動訊號的爭議:使用者互動訊號(點擊率、停留時間)到底算不算直接排名因素,業界實測與 Google 說法多年來始終有落差;與其追逐訊號,不如把力氣花在意圖匹配與內容品質上,這是兩邊都認可的方向。
AI 搜尋也從搜尋索引找答案
AI 搜尋並沒有繞過搜尋索引,而是更依賴它:Google 官方明確說明,AI Overviews 與 AI 模式的連結來源取自 Google 搜尋的既有索引,也「沒有額外的收錄條件,不需要特殊優化」。
Google 的 AI 功能運作時會使用「query fan-out」技術──把一個問題拆成多個子查詢、同時到索引中檢索──再彙整出答案與引用連結。這代表:被抓取、被索引,正是被 AI 引用的前提;控制內容是否出現在 AI 功能中,用的也是同一套機制(Googlebot 的 robots.txt 規則、nosnippet、noindex 等),而 Google-Extended 只影響 AI 模型訓練與其他系統的取用,不影響搜尋收錄。

其他 AI 平台同樣靠檢索器與索引運作:ChatGPT 搜尋使用 OAI-SearchBot 抓取與收錄網頁,Perplexity 用 PerplexityBot 建立自己的索引。想被這些平台引用,第一步同樣是確認 robots.txt 沒有把它們擋在門外。而且各平台的引用來源重疊度很低──ChatGPT 與 Perplexity 引用網域的重疊僅約 11%──同一套「可抓取、可索引、答案明確」的基本功,要能同時對多個索引生效。
品牌聲量的分量:Ahrefs 針對 7.5 萬個品牌的研究顯示,品牌被提及與 AI 可見度的相關係數為 0.664,高於反向連結的 0.218(Ahrefs,2025,轉引自 Omnibound)──AI 搜尋時代,品牌聲量與內容基本功缺一不可。
我們替板橋與台中的客戶做 GEO(Generative Engine Optimization,生成式引擎優化)健檢時,第一件事仍然是回頭檢查 robots.txt 與網頁索引報表──實務上,AI 能見度的問題十之八九要先回到抓取與索引層解決。想了解 AI 搜尋能見度的完整做法,可參考我們的〈GEO 生成式引擎優化服務〉。
本地搜尋:Google 商家檔案與在地排名
本地搜尋有一套獨立的排名邏輯:Google 依關聯性、距離、名氣三項因素決定在地結果的順序,而經營在地排名的第一步,是登錄並完善 Google 商家檔案。
如果您有實體店面或提供到府服務,請先登錄並完善「Google 商家檔案」(Google Business Profile,即原本的 Google My Business,已於 2021 年更名)。Google 對本地結果有一套獨立的排名邏輯,主要看三件事:
- 關聯性:商家資訊與搜尋需求的符合程度──類別、服務項目、營業說明越完整越好。
- 距離:與搜尋者所在位置或查詢指定地點的遠近。
- 名氣:商家在線上與現實世界的知名度,包括 Google 評論的數量與內容、網站本身的自然排名,以及各平台商家資料(名稱、地址、電話,NAP)的一致性。
本地搜尋同時也吃前面講的所有基本功:網站被正確抓取、索引,仍是本地排名的地基。
常見問題 FAQ
網站上線後多久會被 Google 索引?
通常從數天到數週不等,沒有保證時程。可以在 Search Console 提交 sitemap、用網址審查工具「要求建立索引」來加速;有外部連結指向的新網站通常更快被發現。收錄進度請在網頁索引報表追蹤。
如何確認某個網頁有沒有被 Google 收錄?
最準確的方式是在 Search Console 用網址審查工具查詢該網址,它會直接顯示這個網址是否已在 Google 服務中。「site:網址」搜尋只能當概略參考,顯示的數量並不精確。
robots.txt 和 noindex 有什麼不同?
robots.txt 管「能不能抓取」,noindex 管「能不能收錄」。想讓網頁不出現在搜尋結果,用 noindex;若同時用 robots.txt 擋住抓取,Google 反而讀不到 noindex 指令,網址仍可能殘留在索引中。
想被 ChatGPT、Perplexity 等 AI 搜尋引用,要另外做什麼設定嗎?
先確認 robots.txt 沒有封鎖 OAI-SearchBot、PerplexityBot 等 AI 檢索器,其餘與 SEO 基本功相同:可抓取、可索引、內容直接回答問題。Google 的 AI Overviews 沒有額外收錄條件,網頁被 Google 索引就有機會被引用。
沒有提交 sitemap,網站就不會被收錄嗎?
不是。只要有連結可以走到,Googlebot 仍能發現並收錄網頁。sitemap 的作用是讓發現更快、更完整,對新網站、大型網站與更新頻繁的網站特別重要,仍建議提交。
更新紀錄
- 初版:《SEO 初學者指南》第二章,譯介自 Moz《The Beginner's Guide to SEO》。
- 2026 年 8 月 27 日:全面改寫。移除已下架的 Search Console「抓取錯誤報告」「網址參數工具」與搜尋結果「頁庫存檔(快取)」相關教學,更新為現行的「網頁索引」報表與「網址審查」工具;新增 JavaScript 渲染、行動優先索引、canonical 與 AI 搜尋章節;《站長指南》《Google My Business》等名稱更新為現行版本。
- 下次檢視:本文預計每半年重新查證一次,並更新本欄。
結論:搞懂搜尋引擎如何運作,SEO 才有著力點
搜尋引擎如何運作,決定了 SEO 該怎麼做:先確認網頁能被抓取(連結可達、robots.txt 正確),再確認能被索引(可渲染、行動版內容完整、canonical 正確、沒有誤植 noindex),最後才是排名層的內容與連結經營。
AI 搜尋的興起沒有改變這個順序,反而讓抓取與索引這兩層地基變得更重要──因為 AI 的答案,仍然是從索引裡找出來的。
想知道您的網站卡在哪一關?我們提供 Search Console 抓取與索引健檢,先確認網頁停在抓取、索引還是排名這一層,再告訴您哪三件事最值得先做。
對文中術語不熟悉,可搭配〈SEO 專有名詞與解說〉閱讀。
參考來源
- Google,〈AI Features and Your Website(AI 功能與您的網站)〉,Google Search Central,2026-08-27 查證。
- Google,〈Mobile-first indexing has landed(行動優先索引全面完成)〉,Google Search Central Blog,2023-10。
- Google,〈Spring cleaning: the URL Parameters tool(網址參數工具下架公告)〉,Google Search Central Blog,2022-03。
- Search Engine Land,〈Google Search officially retires cache link(頁庫存檔連結正式退場)〉,2024。
- Google,〈網頁索引報表〉與〈網址審查工具〉,Google Search Console 說明,2026-08-27 查證。
- Similarweb 零點擊搜尋數據(2025-07)與 Ahrefs 7.5 萬品牌 AI 可見度研究(2025),轉引自 Omnibound〈Generative Engine Optimization Statistics〉,2026 彙整。
- Moz,〈The Beginner's Guide to SEO〉,本文初版之譯介來源。
- 轉角網路SEO行銷,〈SEO 是什麼?2026 初學者完整指南〉,corners.com.tw,2026-08-27 查證(本站自有內容)。